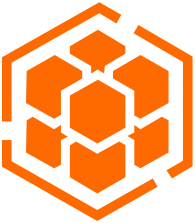
Admin运维控制台
面向集群管理员:用户与配额治理、GPU 资源全景、节点诊断与成本洞察,一屏尽览。
- ElasticQuota 弹性配额树
- 节点 GPU 分布与 Node Shell
- Grafana 监控与成本分析
 容器服务 ACK 出品
Open Source · Apache-2.0
基于阿里云容器服务 ACK 的开源工具链,为数据科学家与算法工程师提供 模型开发、分布式训练、推理服务与集群运维的完整闭环。
# 克隆仓库,一条 Helm 命令完成部署(必填参数见部署指南)
$ git clone https://github.com/AliyunContainerService/data-on-ack.git
$ helm install ai-dashboard data-on-ack/charts/ack-ai-dashboard -n kube-ai \
    --set admin-ui.dashboard.ingress.hosts[0].host=<你的域名> \
--set grafana.adminPassword=<你的密码> # + Prometheus 数据源Ray on ACK · 生产实践
十篇经过生产验证的实战指南:从第一个 RayCluster,到 eRDMA 上的高性能传输——每一步都有可直接复制的 YAML 与命令。
# 通过 KubeRay 一键部署 RayCluster(1 head + 1 worker)
$ kubectl apply -f ray-cluster.yaml
raycluster.ray.io/demo-ray-cluster created
$ kubectl get pods
demo-ray-cluster-head-mgdnb                1/1   Running
demo-ray-cluster-worker-group-worker-lvbr2 1/1   Running
$ kubectl exec -it $HEAD_POD -- ray status
Idle: 1 worker-group, 1 headgroup · 2 CPUs readycGPU 共享显卡、ElasticQuota 弹性配额,把每一块 GPU 用到极致。
Ray Direct Transport 与 NIXL 跑在 eRDMA 上,参数同步与数据搬运告别 TCP 瓶颈。
GCS 容错、RBAC 认证、Plasma 对象溢出——直面真实生产场景,而非玩具示例。
悬停或点按节点,查看 RayCluster 各角色的职责
Two Consoles, One Platform
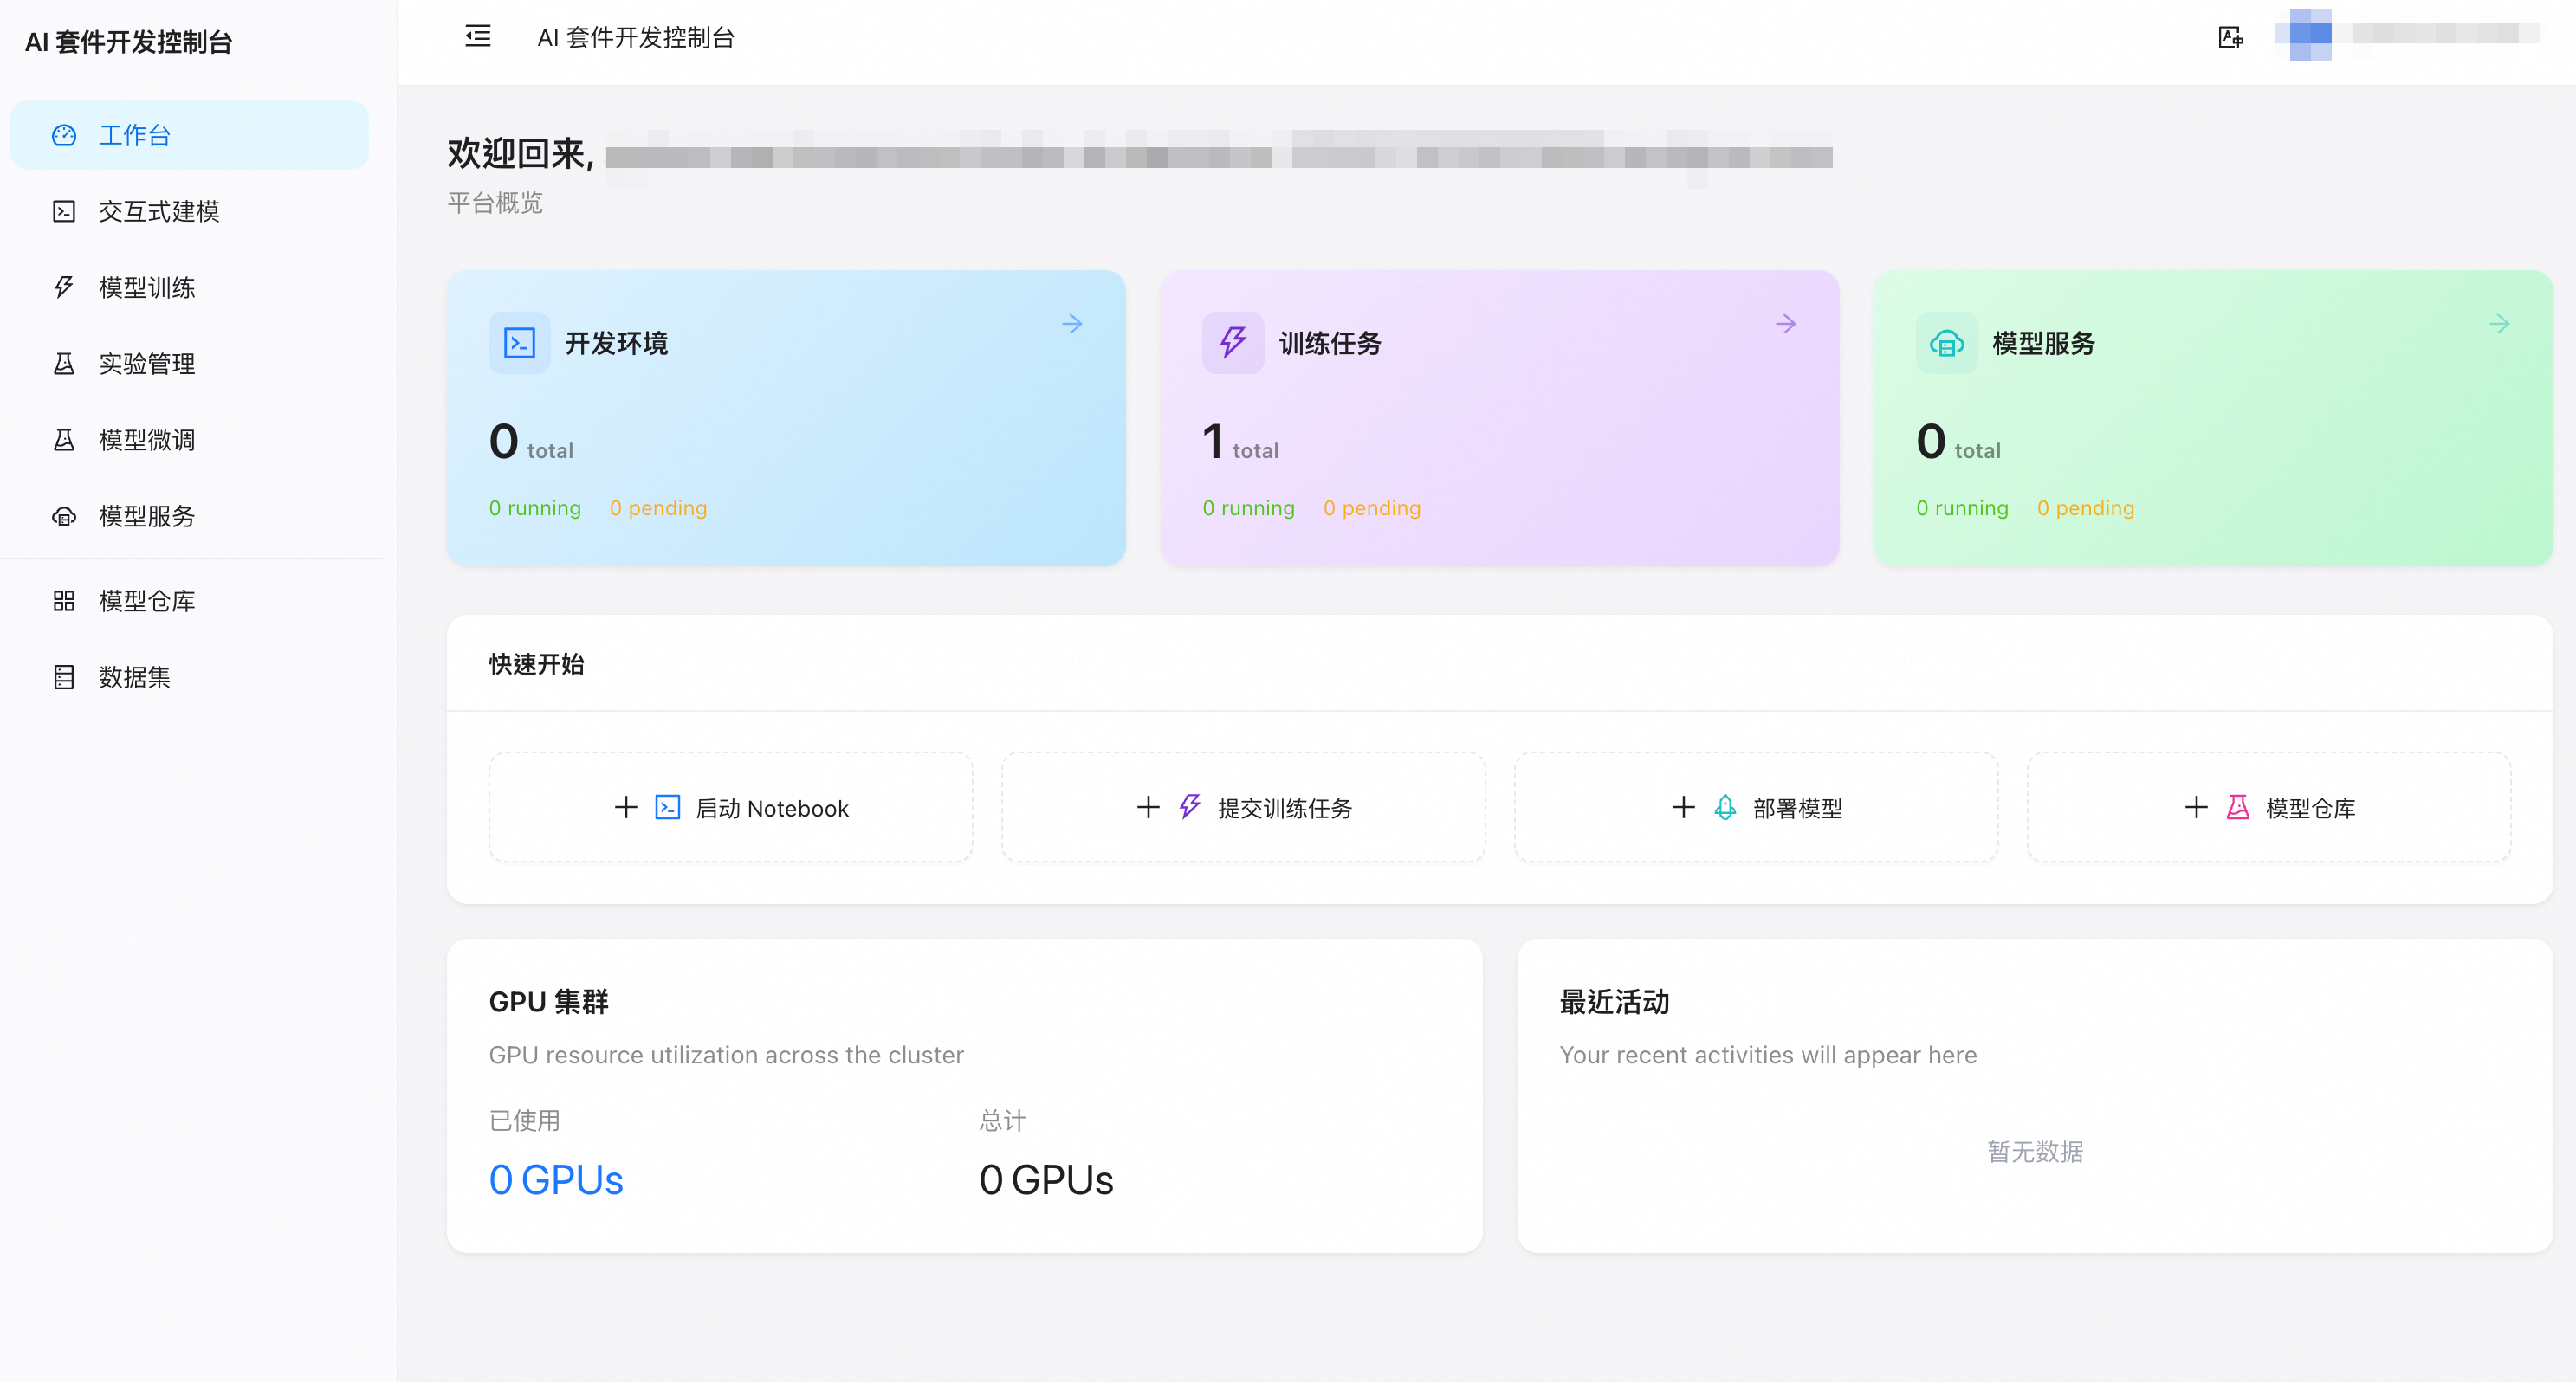
管理员掌控集群治理,算法工程师专注模型迭代——各司其职,互不阻塞。
Capabilities
Jupyter 与 VSCode Notebook 秒级创建,代码经 Commit Agent 自动同步,环境可复现。
集成 Arena 与 Ray,支持 PyTorch / TF 多机多卡训练,任务排队与优先级调度开箱即用。
模型一键部署为在线服务,支持灰度与弹性伸缩,从实验到生产一步到位。
ElasticQuotaTree 多级配额管理,团队间资源共享与隔离兼得,GPU 利用率最大化。
按团队、任务维度追踪 GPU 成本,账单归因清晰,让每一份算力投入都有回响。
RAM 身份集成、用户组隔离、审计与备份恢复,满足生产环境的合规与稳定性要求。
Architecture
所有组件以 Helm Chart 交付,运行在标准 Kubernetes 之上,无厂商锁定。
悬停或点按节点,查看每个组件的职责
Documentation